Learn more about Multimodal Learning

通过代码生成实现模块化视觉问答
由加州大学伯克利分校的博士生Sanjay Subramanian和Google Research感知团队的研究科学家Arsha Nagrani发布 视觉问答(VQA)...
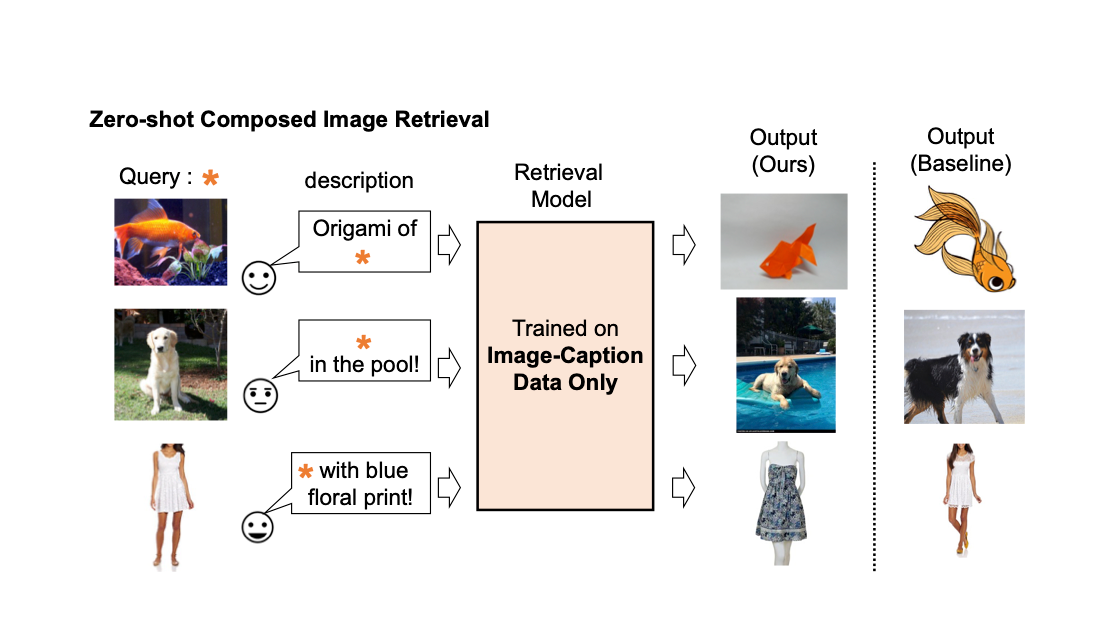
Pic2Word:将图片映射到词语,实现零样本组合图像检索
由谷歌研究的学生研究员Kuniaki Saito和研究科学家Kihyuk Sohn发布,云AI团队的谷歌研究团队 图像检索在搜索引擎中起着至关重...
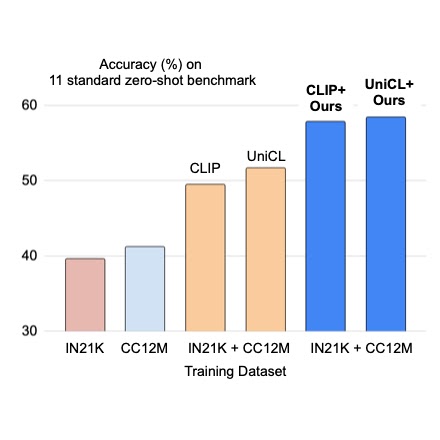
使用前缀条件统一图像说明和图像分类数据集
作者:齐藤邦明(学生研究员,云端AI团队)和孙起赫(研究科学家,感知团队) 最近,通过在大规模图像字幕数据集上对视觉语言...
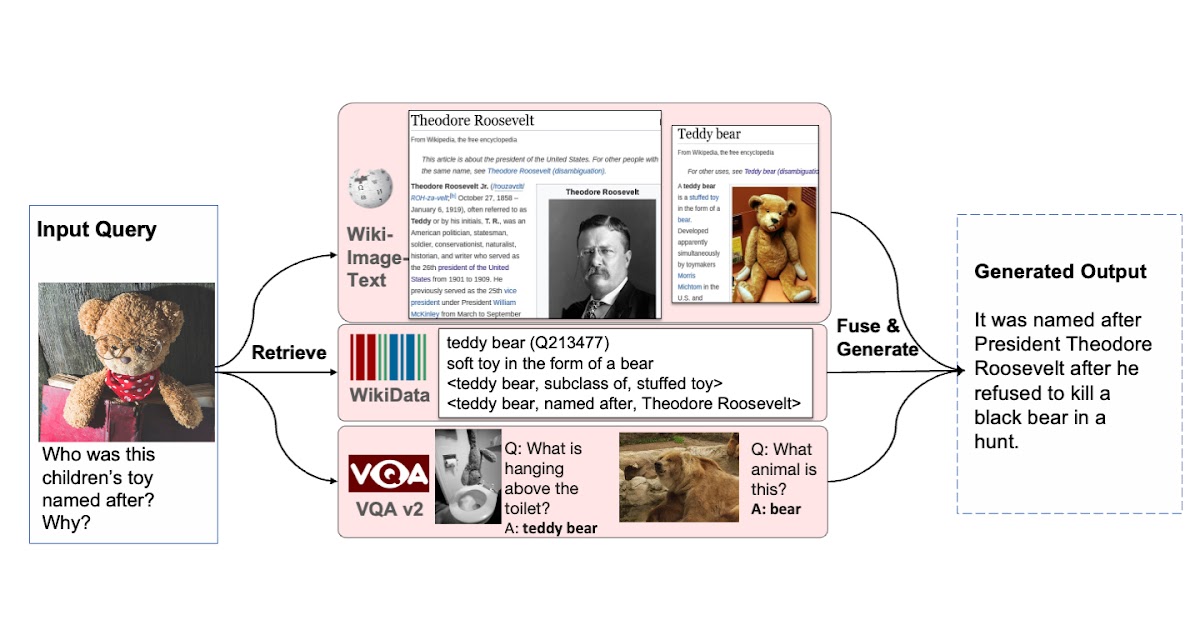
检索增强的视觉语言预训练
作者:胡子牛(Ziniu Hu),学生研究员,法提阿利(Alireza Fathi),研究科学家,Google研究,感知团队 大型模型(例如T5,G...

- You may be interested
- Gradio 正式加入 Hugging Face!
- 莱斯大学和印度理工学院坎普尔校区宣布合...
- 在Delta表中的删除向量 加快在Databricks...
- 使用Amazon SageMaker Python SDK从Amazon...
- “令人难以置信的虚拟化:梅赛德斯-奔驰准...
- 使用检索增强生成来减少AI幻觉
- 来自伦敦帝国理工学院和DeepMind的研究人...
- 用LangChain、Activeloop和GPT-4逆向工程R...
- 与Vikas Agrawal一起揭秘数据科学生态系统
- 亚马逊的新机器人正在推动自动化革命
- 谷歌揭示在AI训练中使用公共网络数据
- 「GBM 和 XGBoost 之间有什么卧槽的区别?」
- 熔炉:多智能体强化学习评估套件
- “《AI是如何工作的:从巫术到科学》的作者...
- 英伟达和Hexagon推出一系列解决方案,加速...