Learn more about Categorical Data
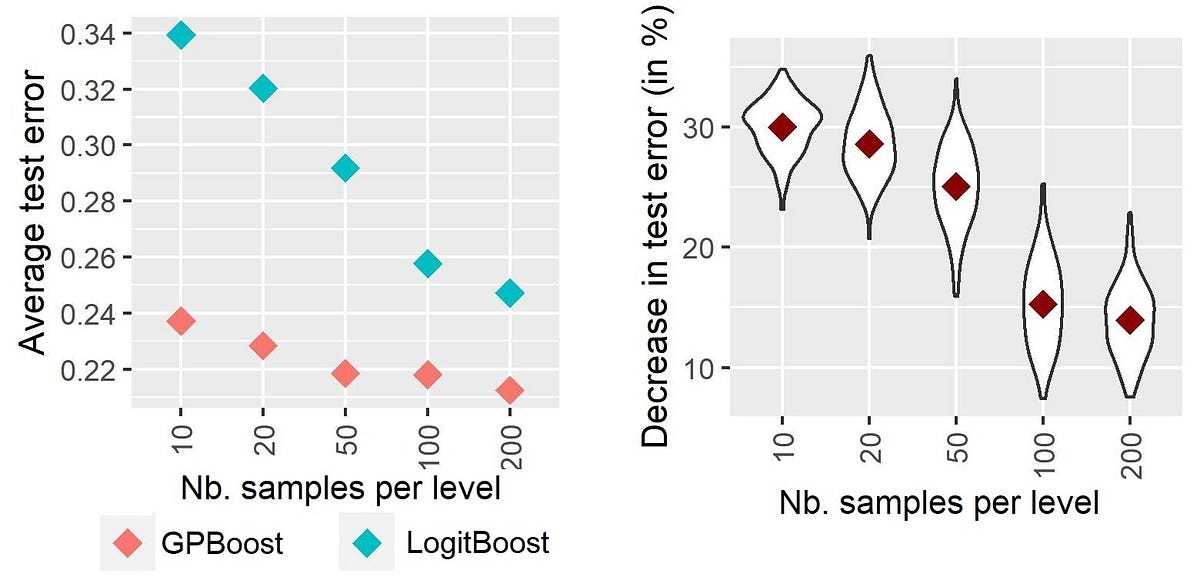
高基数分类变量的混合效应机器学习 —— 第一部分:不同方法的实证比较
机器学习中的随机效应:更好地对高基数分类变量进行建模——方法介绍与比较

- You may be interested
- 从时间晶体到虫洞:何时才算是真正的量子...
- 外行指南:人工智能是否真的能杀死我们所有人
- 如何更高效地存储历史数据
- 人工智能生成内容(AIGC)中的视频扩散模...
- 这篇人工智能论文提出了一种新的预训练策...
- 驾驭变革之风:2024年关键技术趋势
- 通过AI驱动的预测分析彻底改变非营利组织...
- 深度学习深挖:人工智能揭示了秘鲁沙漠中...
- 使用 ChatGPT 进行高效调试
- “释放文本的潜力:对预嵌入文本清理方法的...
- Pixel 8 Pro — 第一款搭载人工智能的智能...
- 宣布 Hugging Face Fellowship 计划
- 如何高效培训您的LLM?小规模实施的最佳实践
- 如何制作自定义ChatGPT(3个简单步骤)
- 美国法院否决AI生成的艺术享有版权的要求